网页爬虫入门教程零基础学会数据采集
很多人一听网页爬虫就觉得是程序员才玩的东西,其实真没那么玄乎。我当初也是纯小白,连代码都看不懂,后来硬着头皮摸索了半个月,现在抓个商品价格、批量下点公开资料完全没问题。这篇就把我踩过的坑和实际用下来的经验整理出来,给想入门数据采集的朋友一个参考。全程不整虚的,都是能直接上手的东西。先说清楚,网页爬虫不是让你去搞别人隐私或者搞破坏,抓公开数据、做点小工具才是正路。
先搞明白网页爬虫到底在干啥
简单说,网页爬虫就是写个小程序,替你打开网页、把你要的内容挑出来存好。你手动复制粘贴一百条数据得半小时,爬虫几秒钟搞定。刚开始别想着搞多复杂,先理解一个页面是怎么请求回来的,浏览器按 F12 能看到源码,你要的东西基本都藏在里面。我建议新手先用浏览器开发者工具看看元素结构,心里有个数再动手写代码。常用的入门语言就是 Python,库的话 requests 拿页面、BeautifulSoup 解析内容,这两个组合够你应付大部分静态页面了。别一上来就研究框架,容易劝退。我当初就是贪多,装了一堆东西结果跑不起来,后来老老实实从最简单的开始才顺过来。
环境搭建和第一个小爬虫
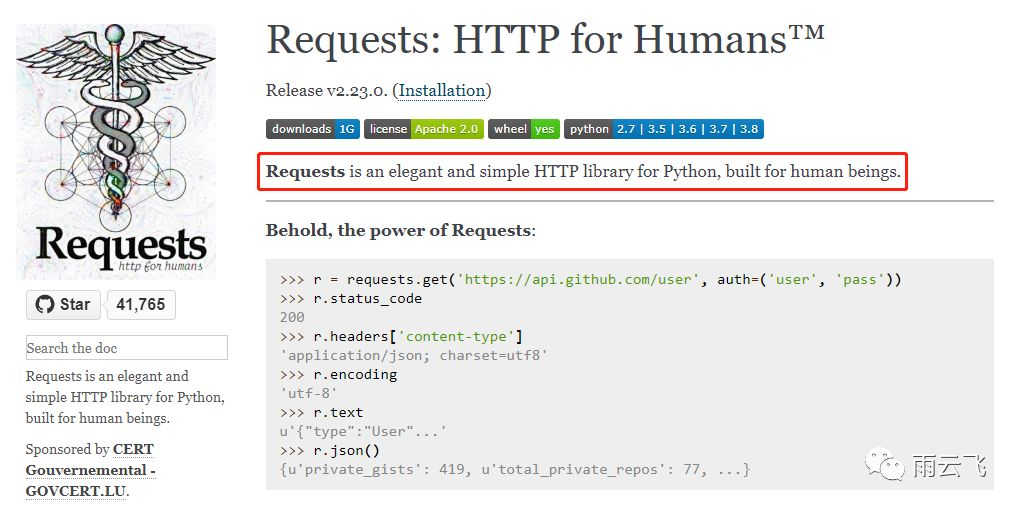
装 Python 别纠结版本,官网下个新的就行,安装时记得勾选加入环境变量,不然命令行找不到。然后 pip 装 requests 和 beautifulsoup4,两条命令的事。写第一段代码别挑复杂网站,找个结构简单的公开页面练手,比如一些新闻列表或者公开的天气数据。代码逻辑就三步:发请求拿到网页内容、解析出标题和链接、打印出来看看。第一次跑通那一刻还挺有成就感的。这里提醒一句,网页爬虫练习时一定要加请求头,很多网站不带 User-Agent 直接把你拒了,我卡在这上面半天才反应过来。另外请求之间加点延时,别跟打机关枪似的,对人家服务器友好点,也是给自己省麻烦。
新手最容易踩的几个坑
第一个坑就是页面看着有数据,代码一跑是空的。原因多半是内容由 JavaScript 动态加载的,requests 拿到的源码里根本没有。这时候要么换思路找接口,要么上 Selenium 这类工具模拟浏览器,但对新手来说先绕开动态页面更省心。第二个坑是编码问题,中文乱码看着头大,设置一下 response.encoding 基本能解决。第三个坑是翻页,很多列表页 URL 有规律,改个页码参数就能循环抓,先观察几页地址就明白了。还有反爬,频率太高会被封 IP,数据采集要讲究节奏,该停就停。我吃过亏,一口气请求太快,直接被限流,后来老老实实加 sleep 才稳定下来。这些经验书上不一定细讲,自己撞过才记得牢。
进阶方向和合法边界
跑通静态页面之后,可以慢慢接触动态渲染、登录态、数据存 Excel 或数据库这些。但更重要的是知道边界在哪:只抓公开可访问的信息,别碰个人隐私,遵守网站的 robots 协议,商用前看清楚条款。网页爬虫是把好用的工具,用对地方能省大量重复劳动,用歪了就是给自己找事。新手阶段别追求大而全,先把一个完整的小需求从头到尾跑通,比啥都强。等你抓下第一批数据、整理成表格那一刻,会发现入门真没想象中难。

 电鸽app免费下载正版
 慢脚文化软件app官方下载(快手)
 JMComic21.7.9最新版安装包下载
 超自然行动组小抄版
 魅影游客登录版下载官方正式版手机(魅影直播)
 P upg国际服3.5(PUBG MOBILE)