事件incidentio平台故障应急响应指南

说实话,谁都不想半夜被报警电话叫醒,但事件incidentio平台真出故障的时候,慌是没用的,得有一套能照着走的流程。这篇就按我自己踩过的坑,把从发现异常到恢复业务、再到事后复盘的全过程捋一遍,不管你是运维值班还是技术负责人,看完至少知道第一步该干嘛,不至于手忙脚乱。下面这些内容都是实战里磨出来的,不是纸上谈兵。
先搞清楚:到底是平台故障还是你自己的问题
很多人一看到报错就急着甩锅给平台,结果查半天发现是自己网络或者配置的问题。事件incidentio平台故障的第一判断标准,其实是看影响范围。如果只有你一个人访问不了,先别急着发工单,本地网络、DNS、浏览器缓存都过一遍。要是整个团队同时掉线,那基本可以确定是平台侧出事了。这时候别反复刷新页面浪费时间,直接去看官方状态页,或者事件incidentio的社区公告,通常几分钟内就会有动静。我一般会顺手在群里问一句“还有谁挂了”,确认是普遍现象再启动应急。另外提醒一句,事件incidentio平台故障有时候表现为接口超时而不是直接报错,这种隐蔽性更强,监控里的响应时间曲线比错误率更早能看出苗头。
应急处理:先止损,再查原因
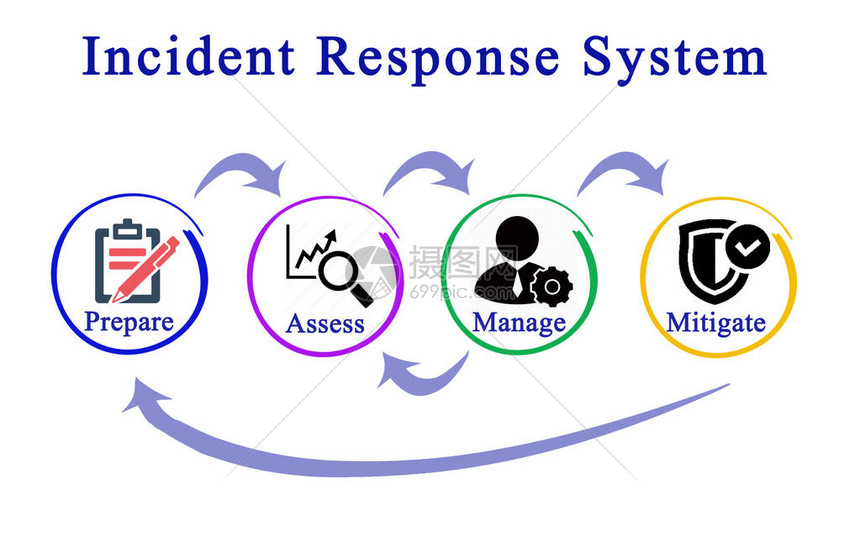
确认是事件incidentio平台故障之后,第一原则是保住业务,别一上来就深挖根因。先把受影响的业务模块切到降级方案,比如关掉非核心功能、走本地缓存、或者临时启用备用通道。这一步很多团队容易忽略,结果故障拖了半小时才想起来降级,损失已经造成了。事件incidentio平台故障应急响应的核心动作就三个:隔离、降级、通报。隔离是把故障范围和正常业务分开,降级别让用户感知太差,通报是让相关方知道进展,别让人干等着。通报这块我建议用固定模板,几句话讲清楚影响范围、当前处理状态、下次更新时间,别写小作文。还有,事件incidentio平台故障期间别频繁重启服务,很多问题重启反而会放大,先看日志再动手。
故障恢复后,这几件事别漏了
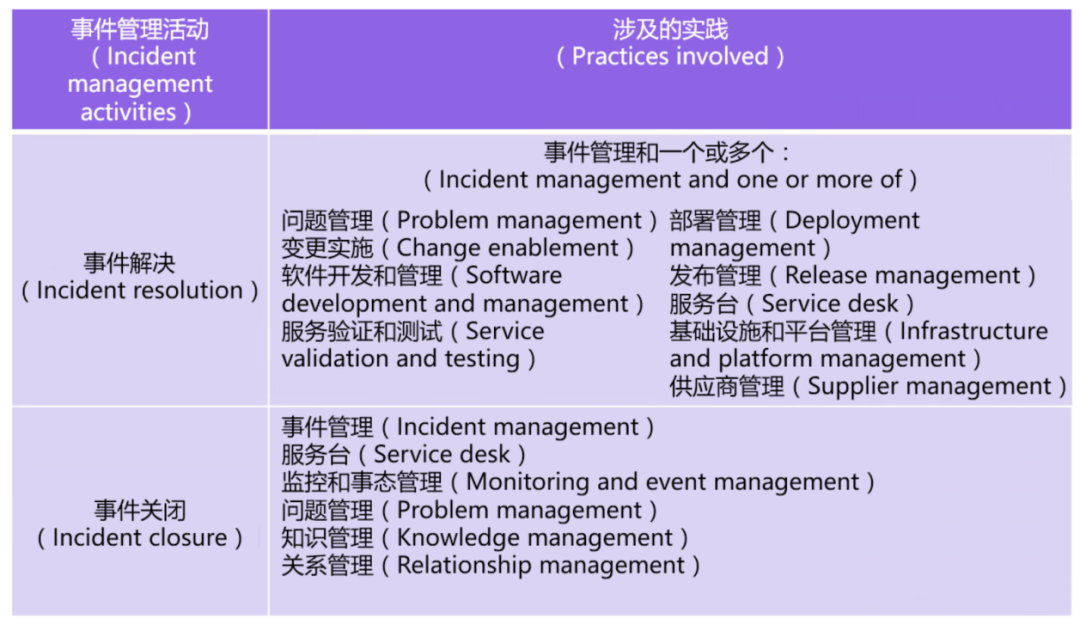
平台恢复了不代表事情结束。事件incidentio平台故障处理完之后,第一时间要验证核心链路是不是真的正常,别只看首页能打开就完事,下单、支付、登录这些关键路径都得跑一遍。然后是把故障时间线整理出来,几点几分发现、几点几分响应、什么时候恢复,这些数据后面复盘要用。我见过不少团队故障一恢复就散了,结果下次遇到同样的问题还是手忙脚乱。事件incidentio平台故障的复盘不用搞得太正式,拉个半小时的会,把根因、影响、改进项对一遍就行,重点是改进项要落到人头上,有截止时间,不然就是空谈。另外,如果是平台侧的故障,记得把官方公告和工单记录存一份,后面跟客户解释或者写报告都用得上。
平时做点什么,故障来了能少受罪
事件incidentio平台故障这种事,防是防不住的,但可以把损失控住。平时建议把关键业务的监控告警配好,尤其是响应时间和错误率两个指标,比人工发现快得多。再就是定期演练一下降级方案,别等真出事才发现备用通道根本不通。还有个小细节,事件incidentio平台故障期间沟通渠道要提前定好,是用群还是用电话,别到时候一半人在群里一半人在邮件里,信息对不上。最后说句实在的,应急响应能力不是看文档写得多漂亮,是看真出事的时候团队能不能按流程动起来,平时多练一次,故障时就少慌一分。











 慢脚文化软件app官方下载(快手)
 电鸽app免费下载正版
 JMComic21.7.9最新版安装包下载
 超自然行动组小抄版
 魅影游客登录版下载官方正式版手机(魅影直播)
 P upg国际服3.5(PUBG MOBILE)