声对是什么 声对技术原理与应用场景全解析
最近老有人问我声对是什么,说是在一些智能设备和软件设置里看到这个词,但网上搜出来的解释要么太学术,要么讲得云里雾里。我自己前阵子折腾智能音箱和车载语音的时候也踩过坑,干脆把这东西从头到尾捋一遍。其实声对没那么玄乎,你可以把它理解成一套让机器“听懂谁在说、说了啥、该咋回应”的匹配逻辑。它跟单纯的语音识别还不一样,识别只是把声音转成文字,而声对要解决的是声音和指令、声音和设备、声音和场景之间的对应关系。搞明白这一点,后面看原理和应用就顺了。
声对技术原理到底怎么跑起来的
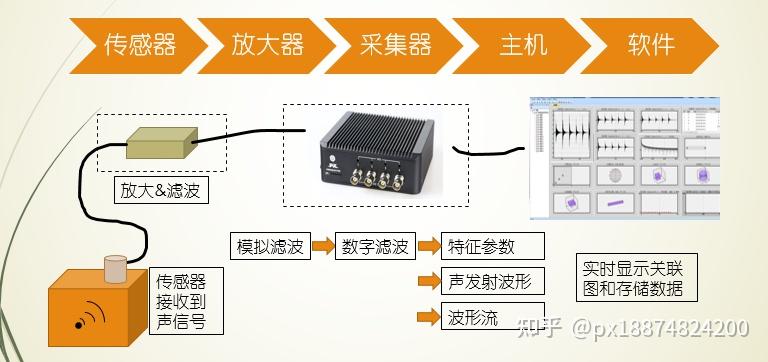
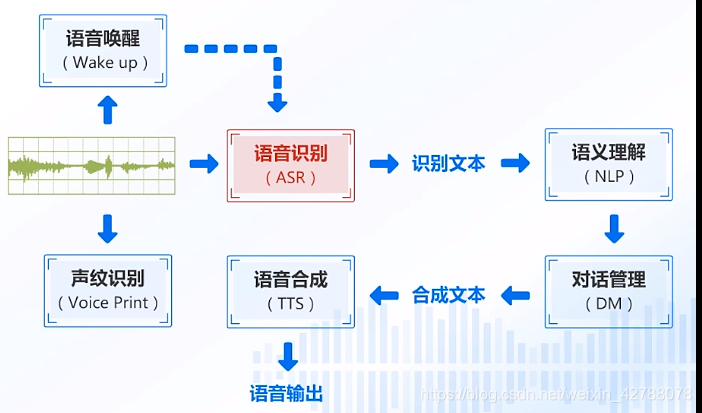
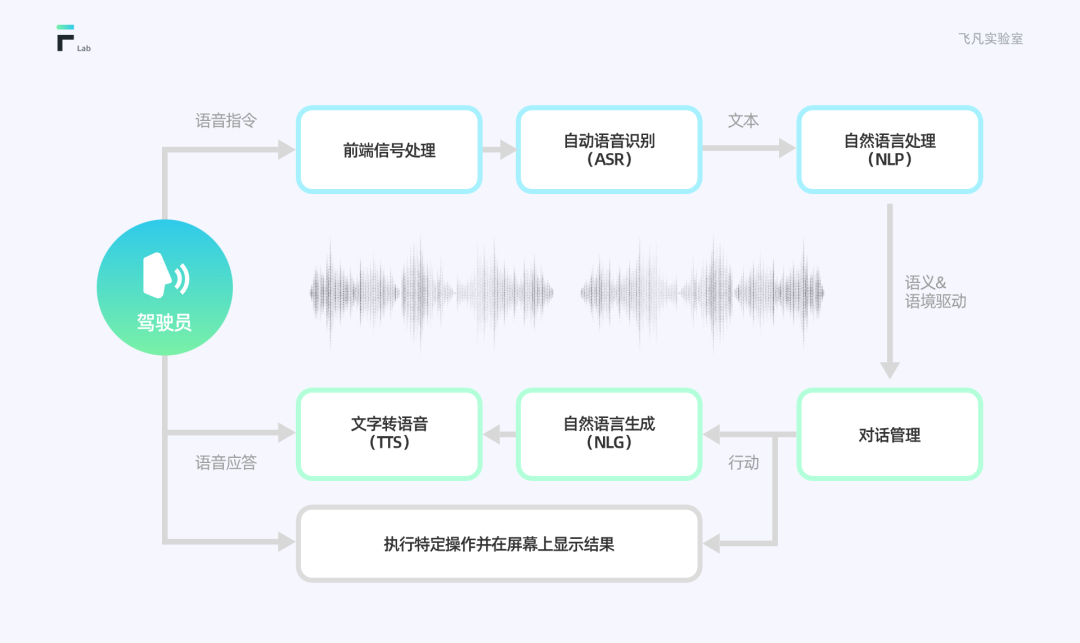
先说原理,不整那些公式。声对的核心流程大概分三步走。第一步是拾音和降噪,麦克风阵列把周围声音收进来,但环境里杂音很多,空调声、电视声、别人说话声都混在一起,所以得先做声对预处理,把有效人声拎出来。第二步是特征提取和比对,系统会把你的声音切成很短的帧,提取音高、音色、语速这些特征,然后跟数据库里已有的声纹或者指令模板做匹配。这一步就是声对最关键的“对”字所在,对上了才继续往下走。第三步是决策输出,匹配成功就执行对应操作,比如开灯、切歌、导航,匹配失败就提示重说或者忽略。
我拿自己那台智能音箱试过,安静环境下声对成功率挺高,基本喊一声就应。但厨房开着抽油烟机的时候,得凑近点大声说才行,这就是拾音和降噪没扛住。所以别迷信参数,实际环境对声对效果影响特别大。另外声对还分本地和云端两种,本地响应快但库小,云端库大但依赖网络,选设备的时候得看自己常用场景偏哪边。
声对在生活里到底能用在哪些地方
应用场景这块其实比想象中多。最常见的就是智能家居,你喊一声“打开客厅灯”,音箱得先做声对判断是你本人在说,而不是电视里的人在说,不然就乱套了。还有车载语音,方向盘上按一下说话,系统要声对出是主驾还是副驾在指令,因为有些功能只有主驾能操作。手机上的语音助手也一样,声对能区分机主和旁人,避免别人拿你手机乱喊。
再往深一点,安防领域也用得不少。有些门禁系统号称声纹开门,其实就是声对技术在撑腰,提前录好声纹,来人说话时做比对,对上了才放行。不过我得提醒一句,这玩意儿受感冒、情绪影响挺大,我感冒那几天试过,自家门禁都认不出我,所以别把它当唯一验证手段。另外客服质检、会议记录转写这些场景也在用声对做说话人分离,谁说的哪句话能标得清清楚楚,省了不少人工回听的时间。
普通人选声对产品要避开哪些坑
最后聊点实在的。如果你是想买带声对功能的设备,别光看宣传页写得多牛,重点看两件事。一是看它支持本地声对还是必须联网,联网的一断网就废了,本地的一般更稳。二是看声对库能不能自己录,有些便宜货只能识别固定几个指令,稍微换个说法就歇菜。我自己踩过的坑就是买了个便宜音箱,说明书说支持声对,结果只能对“打开灯”“关闭灯”这两句,换个“把灯关了”它就懵了。所以声对这东西,库的丰富度和自适应能力比单纯堆麦克风数量重要得多。日常用的话,选支持自定义声对指令、且能离线跑基础功能的设备,体验会好很多。
总结一下,声对就是让机器把声音和意图正确配对的技术,原理不复杂但实际表现看调校,应用场景已经从智能家居铺到车载、安防、办公。搞懂这些,下次再看到声对相关的设置项,你就知道该关注哪些参数了。

 超自然行动组小抄版
 魅影游客登录版下载官方正式版手机(魅影直播)
 JMComic21.7.9最新版安装包下载
 P upg国际服3.5(PUBG MOBILE)
 引力圈app官方版最新版本下载(UniFans)
 慢脚文化软件app官方下载(快手)